Konteks Peristiwa
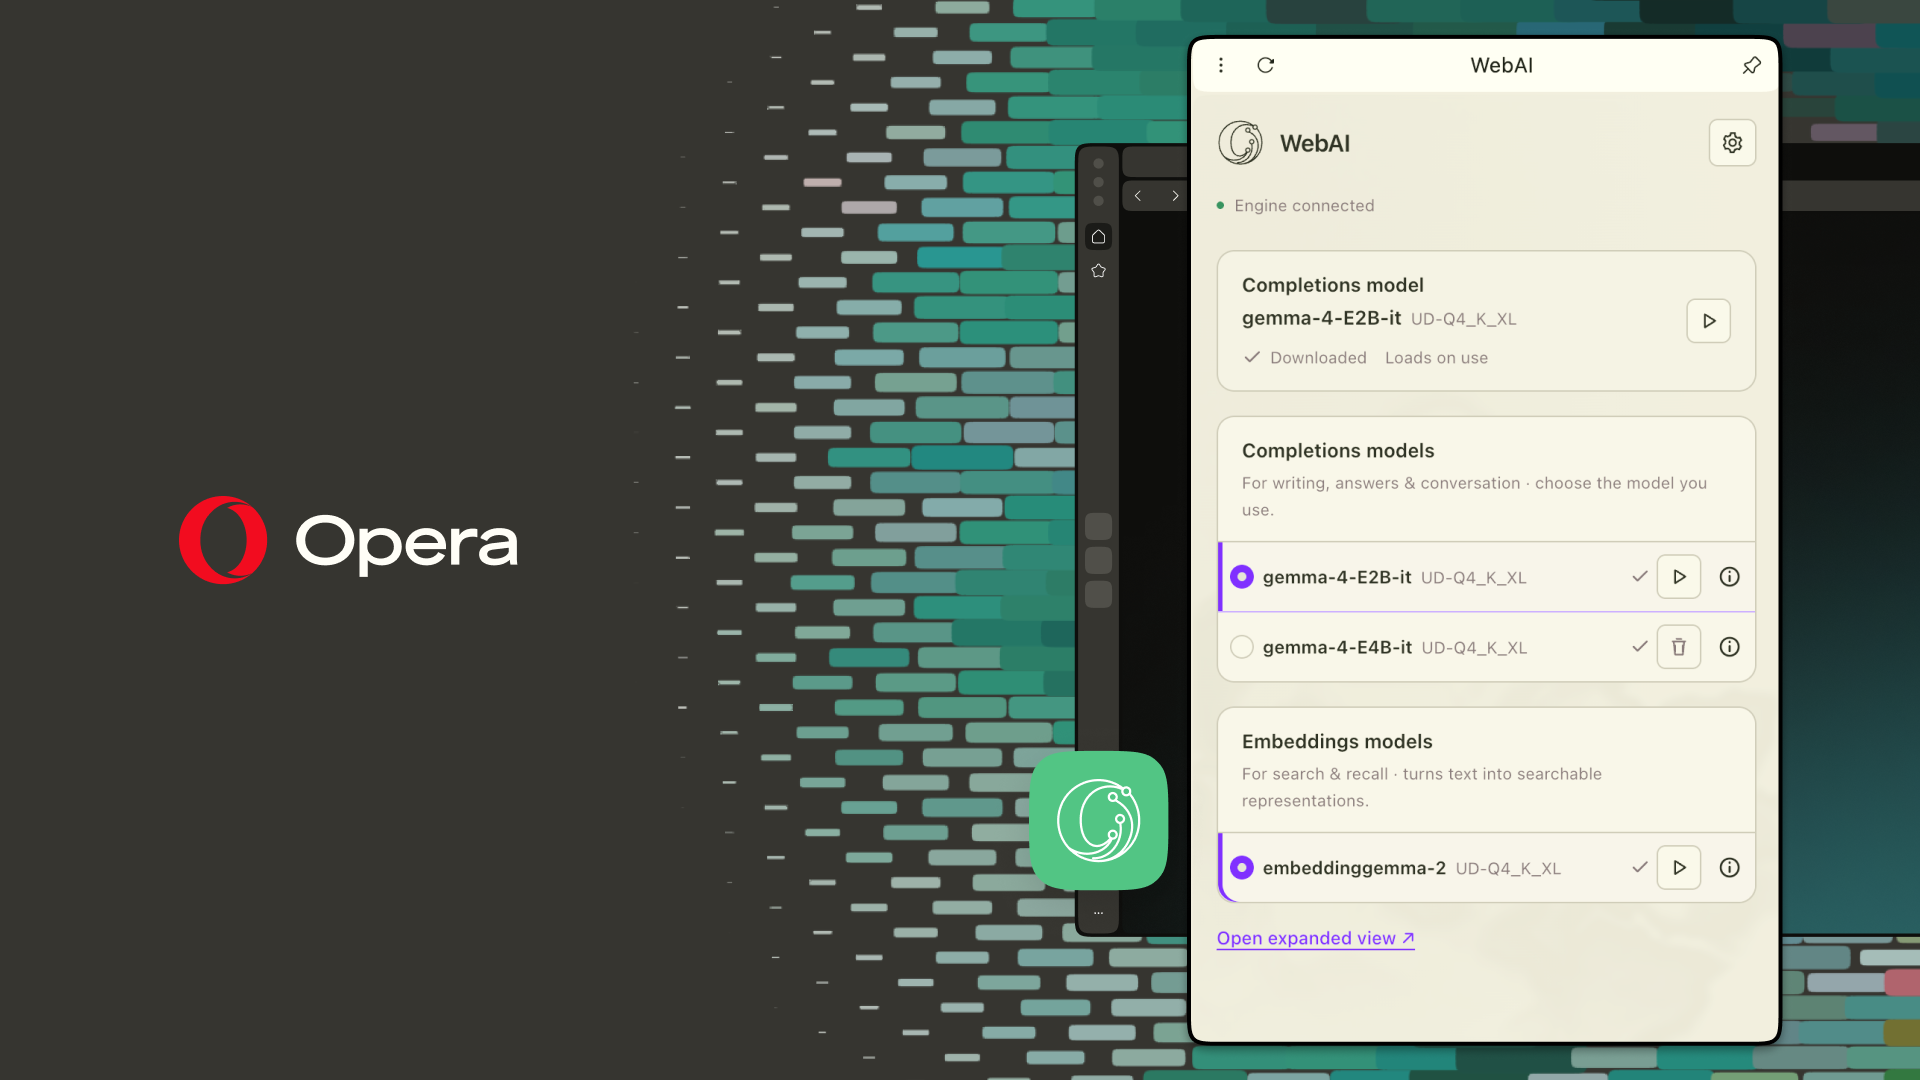
Pengembang peramban Opera resmi meluncurkan inisiatif WebAI, sebuah usulan standar web terbuka yang memungkinkan aplikasi web dan ekstensi browser menjalankan model kecerdasan buatan langsung di perangkat lokal pengguna (on-device). Inisiatif yang turut didukung oleh raksasa teknologi seperti Google dan Microsoft ini dirancang untuk memecahkan hambatan adopsi AI di web, di mana pengembang selama ini terbebani biaya langganan API berbasis token serta latensi jaringan ke server terpusat. Fitur ini mulai digulirkan dalam tahap early preview pada browser Opera One, serta direncanakan segera hadir untuk Opera GX dan Opera Neon.
Melalui WebAI, Opera menanamkan inference engine mandiri ke dalam peramban sehingga pengguna tidak perlu mengunduh aplikasi AI terpisah, mengonfigurasi server lokal yang rumit, atau meminta API key komersial. Standar ini bersifat model-agnostic dan mendukung ekosistem model open-weight populer seperti keluarga Gemma dari Google, serta terintegrasi langsung dengan model fondasi bawaan perangkat pada sistem macOS berbasis Apple Silicon. Seluruh mekanisme inferensi berjalan secara opt-in, di mana model komputasi hanya akan diunduh ke penyimpanan lokal setelah pengguna memberikan izin eksplisit melalui menu pengaturan.
Standar WebAI memperkenalkan tiga antarmuka pemrograman utama, yaitu Prompt API untuk generasi teks dan penalaran, Decision API untuk klasifikasi konten otomatis, serta Semantic Embeddings API untuk memetakan keterkaitan semantik antar-data secara instan. Kehadiran ketiga API ini memungkinkan pengembang independen menciptakan fitur-fitur kontekstual yang sebelumnya mahal—seperti filter cerdas lowongan kerja, peringkas dokumen privat, hingga pencarian semantik riwayat browsing—tanpa perlu mengoperasikan klaster GPU mandiri di cloud.
Selain aspek efisiensi biaya bagi pengembang, arsitektur lokal WebAI menawarkan jaminan privasi data pengguna yang fundamental. Mengingat seluruh pemrosesan inferensi diselesaikan langsung oleh chip CPU dan GPU komputer pengguna, teks dokumen maupun perintah sensitif tidak pernah meninggalkan perangkat atau dikirim ke server pihak ketiga untuk pelatihan model. Kendati kecepatan inferensi sangat bergantung pada spesifikasi perangkat keras masing-masing pengguna, langkah standardisasi ini dinilai sebagai fondasi penting transisi web modern menuju era client-side AI yang lebih privat dan terdesentralisasi.